Il existe beaucoup d'affirmations sur le développement assisté par IA, et très peu de compteurs. Luc Bonnin, dirigeant et développeur, a fait l'inverse : il a mis son équipe de développement de côté pendant 40 jours pour la remplacer par des agents, sur un produit réel, et il a mesuré chaque étape.
Le décor est choisi pour être défavorable, et c'est ce qui rend l'exercice intéressant : playthatsheet.com, un monolithe PHP/MySQL d'environ 200 000 lignes, sans framework, et sans framework délibérément. L'objectif était d'empêcher l'IA de s'appuyer sur des patterns connus et d'éviter ce qu'il appelle « l'effet greenfield » - ces démonstrations où l'IA brille parce qu'elle part d'une page blanche. « J'ai donc choisi le pire cas possible », écrit-il, « délibérément pour coller à un cas du monde réel ».
Les compteurs, à l'arrivée :
- 1 477 prompts et 2,3 milliards de tokens, soit 61,2 millions de tokens par jour ;
- un code source qui passe de 178 938 à 439 502 lignes - +145,62 %, un facteur 2,45 ;
- une répartition finale de 59 % d'IA pour 41 % d'humain ;
- et 260 564 lignes relues ligne à ligne par un humain.
C'est ce dernier chiffre qui mérite qu'on s'arrête. Il ne décrit pas ce que l'IA a produit : il décrit ce qu'il a fallu faire pour que ce qu'elle a produit soit utilisable.
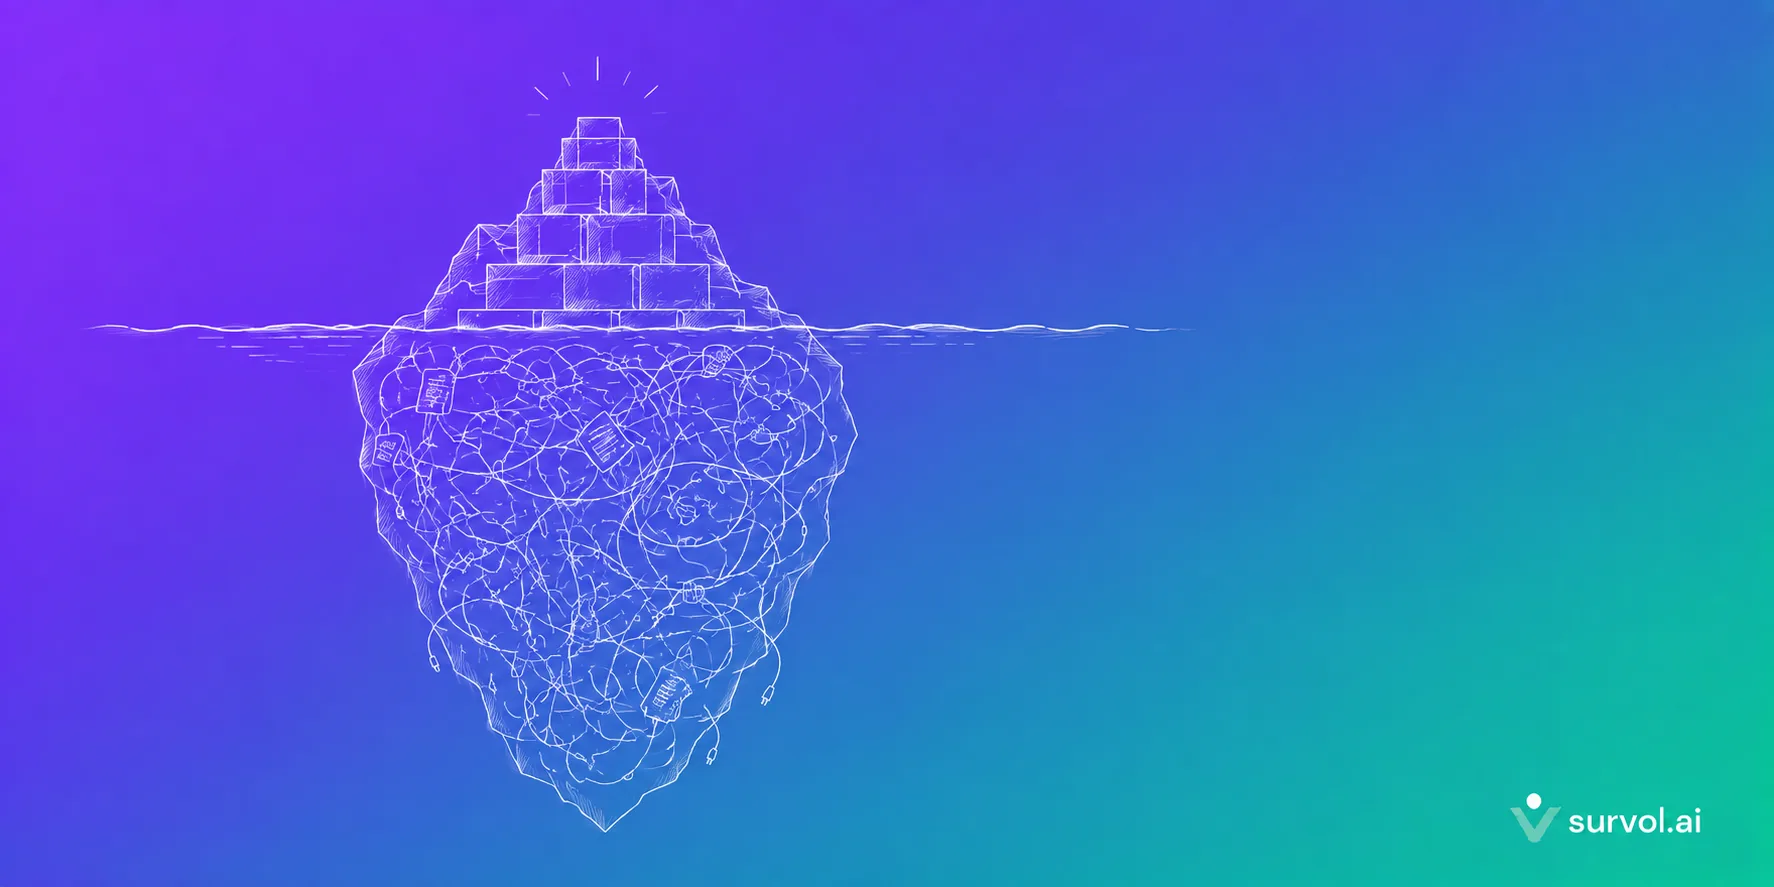
L'effet iceberg : la dette ne disparaît pas, elle change de place
La métaphore centrale du bilan est celle de l'iceberg. Au-dessus de la ligne de flottaison, la partie visible : des fonctionnalités livrées, un dépôt qui grossit, des démonstrations qui impressionnent un comité de direction. En dessous, ce que personne ne compte.
Sous la ligne, dans cette expérimentation, il y avait « plusieurs milliers de lignes » supprimées par
git revert parce qu'elles étaient le fruit d'hallucinations : du code incorrect, incohérent ou
dangereux. Et la remarque qui compte : ces lignes n'étaient pas détectables sans relecture humaine ligne à
ligne. Elles compilaient. Elles passaient les tests. Elles ne faisaient simplement pas ce qu'il fallait.
La dette technique ne disparaît pas avec l'IA : elle se déplace et se camoufle. Et elle s'accélère si un humain ne veille pas au grain.
Le corollaire est désagréable pour qui pilote sans regarder le code : plus la partie visible grossit vite, plus la partie immergée grossit vite aussi, et rien dans un tableau de bord de livraison ne le signale.
Le « monkey money » : un coût que personne ne sait prévoir
Le passage le plus utile du bilan n'est pas celui sur la qualité du code, mais celui sur la facture. Luc Bonnin emprunte à la grande distribution le terme de monkey money - la monnaie de singe, ce point de fidélité que celui qui l'émet est libre de réévaluer quand il veut, parce qu'il n'est indexé sur rien. Dans l'IA agentique, cette monnaie s'appelle le token.
La démonstration est expérimentale, et c'est ce qui la rend solide. Il a écrit quatre prompts pour connecter quatre plateformes d'authentification tierces : même structure, même modèle, mêmes règles, même base de code, une fonctionnalité présente sur des milliers de sites depuis des années - donc en plein dans la zone de confort d'un LLM. Il aurait dû obtenir des consommations proches, voire décroissantes, l'IA réutilisant le code des premières itérations. Il a obtenu 350 % d'écart entre le prompt le moins consommateur et le plus consommateur.
Sa question au dirigeant est la bonne : « quel entrepreneur investirait dans un outil si son utilisation peut varier de 350 % sans raison explicable ? » - sachant que ce risque est multiplié par le nombre de développeurs qui utilisent l'outil, et qu'il faut bien poser une ligne quelque part dans un budget.
Nous avons déjà écrit ici que Uber a brûlé son budget IA annuel en quatre mois et y avons vu un signe de maturité plutôt qu'un échec. Ce bilan-ci explique le mécanisme par en dessous : ce n'est pas seulement que la consommation est élevée, c'est qu'elle est non prévisible à l'échelle du prompt. Un budget peut absorber un coût élevé. Il absorbe beaucoup plus mal un coût qu'on ne sait pas estimer avant de l'avoir dépensé.
Le syndrome du bazooka pour attraper des mouches
Troisième effet, et celui-là ne vient pas de la machine mais des humains qui la pilotent : l'habitude d'appeler le modèle le plus puissant du moment pour la moindre tâche. Changer une ligne de CSS, renommer une variable, corriger une faute dans un libellé - au frontier model, à chaque fois.
Le conseil qui suit est prosaïque et rarement appliqué : regarder du côté des petits modèles, souvent aussi performants sur des tâches modestes, et du côté des modèles ouverts que l'on peut faire tourner localement. Le gain n'est pas seulement sur la facture ; il est aussi écologique.
Ce réflexe a un cousin plus inquiétant, que le bilan appelle l'atrophie : à force de ne plus vérifier, on perd la capacité de vérifier. D'où une recommandation qui semblera conservatrice et qui ne l'est pas : garder délibérément quelques parties du code « faites à la main », pour que l'équipe conserve la compétence dont elle aura besoin le jour où il faudra arbitrer un choix que l'IA a fait à sa place.
Le bateau de Thésée : à qui appartient encore ce code ?
La métaphore la plus littéraire du texte est aussi la plus juste. Le bateau de Thésée, conservé à Athènes, voit ses planches remplacées une à une jusqu'à ce qu'il n'en reste aucune d'origine. Est-ce encore le même bateau ?
Appliqué à une base de code : quand 59 % des lignes ont été écrites par une machine en 40 jours, l'équipe possède-t-elle encore son produit ? Elle en est propriétaire au sens juridique. La question porte sur autre chose - la maîtrise fine, celle qui permet de diagnostiquer une panne à 3 heures du matin sans relire trente fichiers.
Les IA font grossir la partie visible de l'iceberg extrêmement vite, mais les humains perdent tout aussi vite la maîtrise et la paternité de leur œuvre.
« Would I know if the code was wrong ? »
C'est exactement là que le récit de Luc Bonnin rejoint un autre témoignage publié quelques jours plus tôt, celui d'Elie Nehmé, qui a construit en deux mois une plateforme de gestion d'actifs logiciels - backend Spring Boot, frontend Angular, 14 226 lignes de code de production, 16 092 lignes de tests, 25 migrations de base - presque entièrement avec Claude Code.
Sa conclusion n'est pas que l'IA remplace l'ingénierie. C'est qu'elle en déplace le point d'application :
La bonne question n'est plus « l'IA peut-elle écrire ce code ? ». Elle le peut, manifestement. La bonne question est : « saurais-je que ce code est faux ? »
Il a une méthode pour ça, et elle est contre-intuitive : demander à l'IA d'attaquer sa conception avant d'écrire la première ligne, plutôt que de l'aider à la construire. Trois défauts trouvés en amont, dont deux qui n'auraient jamais levé d'exception :
- Une règle de validation qui masquait une période entière. Une décision métier assumée faisait lire à la période d'inventaire les données de l'année précédente ; une règle de validation plus ancienne, restée sur sept routes, exigeait une année supérieure ou égale à 2025. Chaque règle était correcte. Leur combinaison renvoyait un 400 et affichait un écran vide. « Le problème vivait entre deux règles qui avaient l'air justes. Ça, c'est de l'architecture. »
- Une migration à moitié faite qui avait l'air terminée. Elle copiait une table ; la requête réelle en joignait deux. L'application démarrait, les tests passaient, deux niveaux d'organisation restaient vides.
- Une faille déjà en production, trouvée en examinant autre chose : les routes « actifs » n'appliquaient pas la règle de visibilité que les routes « catégories » appliquaient correctement.
Et un dernier exemple, qui devrait figurer dans toutes les formations : l'IA a proposé
set_config('app.changed_by', ?, false) pour renseigner l'auteur d'une modification côté PostgreSQL. Le
troisième paramètre décide de la portée : true pour la transaction, false pour la session.
L'application utilise un pool de connexions. Avec false, la valeur reste attachée à la connexion après
la requête, et la requête suivante - d'un autre utilisateur - écrit ses traces d'audit sous le nom du précédent.
Tous les tests passent. Un caractère, et le journal d'audit devient une responsabilité juridique.
Le point commun des deux récits : la génération de code n'est plus le problème. Ce qui reste difficile, coûteux et non délégable, c'est de savoir que ce qui a été produit est juste.
Le ROI, et ce qu'il ne dit pas
Le bilan chiffre le retour sur investissement, et il faut le citer honnêtement : ×18,15. Le calcul compare 826 jours-hommes d'une squad Agile de cinq personnes à 500 € par jour - un taux volontairement bas, pour ne pas surévaluer le coût humain - à 260 € d'abonnement Cursor plus quinze jours de temps de CTO à 1 500 € la journée. Soit environ 413 000 € contre 22 760 €.
Ce chiffre est spectaculaire, et son auteur est le premier à en poser les limites : il ne tient compte ni de l'effet iceberg, ni de la perte de maîtrise, ni de la dépendance créée envers les vendeurs de tokens.
Il y a une limite de plus, qu'il vaut la peine de nommer. Les quinze jours de temps humain retenus dans le calcul couvrent à la fois la rédaction des spécifications techniques détaillées, les 1 477 prompts et la relecture des 260 564 lignes. Cela fait environ 17 000 lignes relues par jour, spécifications et prompts compris. On peut parfaitement soutenir qu'une relecture de code se fait à ce rythme quand on connaît son propre produit par cœur ; on peut aussi soutenir que quinze jours sous-estiment la charge réelle de supervision. Dans la seconde hypothèse, le ROI reste largement positif - il n'est simplement plus de 18.
Ce n'est pas un reproche fait à l'expérimentation : c'est exactement le genre d'hypothèse qu'une entreprise devrait expliciter avant de refaire le calcul chez elle, avec ses propres taux et ses propres développeurs, qui ne connaissent pas tous la base de code aussi bien que son auteur.
Le paradoxe des « +30 % » enfin expliqué
Voilà pourquoi ce bilan mérite d'être lu par un comité de direction plutôt que par une équipe technique. Il répond à une question que beaucoup de dirigeants posent sans obtenir de réponse cohérente : pourquoi mes équipes disent gagner 30 % de temps grâce à l'IA alors que les plannings de livraison ne bougent pas ?
La réponse tient en une phrase : le gain de vélocité est réel, mais il est absorbé - par la supervision humaine requise, par la dette cachée, par l'imprévisibilité des tokens, et par l'absence de quelqu'un dont c'est le travail de piloter tout ça.
C'est aussi ce que les 8,1 millions de pull requests mesurées par LinearB disaient sous un autre angle : le code humain fusionne à 84,5 %, le code d'IA à 32,7 %. Produire n'a jamais été l'étape limitante. Valider l'est devenu.
La question à poser lundi matin
Le conseil final du bilan est une approche Pareto : utiliser l'IA là où elle bat l'humain à plate couture, et consacrer 20 % du temps humain à conserver la maîtrise de son code, son agilité, et sa capacité à se passer de l'IA si le coût des tokens devenait incontrôlable.
Et une question, qu'on peut poser telle quelle en comité de direction :
Qui, dans votre entreprise, est responsable de la stratégie IA et du forecast de votre consommation de tokens ? Si la réponse est personne, commencez par là.
Ce que Survol en fait
Trois des quatre problèmes décrits ci-dessus sont des problèmes de gouvernance, pas de modèle - et c'est précisément l'étage où Survol opère.
- La dette qui se camoufle. Chez nous, la spécification validée est la source de vérité, pas le prompt jetable. Un écart entre ce qui a été décidé et ce qui a été produit est un écart visible, pas une découverte faite six mois plus tard.
- Le coût imprévisible. Le choix du modèle est automatique selon la tâche, le contexte injecté est réduit au nécessaire - c'est le sujet de notre article sur un contexte taillé sur mesure. Un contexte plus petit, ce sont des tokens moins nombreux et une variance plus faible. Le bazooka n'est pas sorti pour une mouche.
- La paternité perdue. Chaque session laisse une trace : qui a demandé quoi, à quel agent, sur quelle branche, avec quel contexte, et quelles contraintes d'organisation ont été contestées. La base de code reste racontable, ce qui est la seule définition opérationnelle de « la maîtriser ».
Reste le quatrième problème, celui du capitaine. Aucun outil ne le règle : il faut quelqu'un. Mais un outil peut au moins lui donner les chiffres dont il aura besoin pour tenir le poste.
Sources
- Luc Bonnin, « J'ai viré mon équipe de dev pour une équipe 100 % IA pendant 40 jours et 2,3 milliards de tokens », LinkedIn, 13 mai 2026.
- Elie Nehmé, « AI Writes the Code. So What Is the Engineer's Job Now? », Medium, 15 août 2026.